Blog
Inference Engineering mit vLLM und llm-d
Ein Sprachmodell auf einer GPU zu starten, ist heute vergleichsweise einfach. Hunderte unterschiedlich lange Anfragen zuverlässig zu bedienen, ist eine andere Aufgabe. Während ein Mitarbeiter eine kurze Frage stellt, lädt der nächste einen langen Vertrag hoch. Beide erwarten eine schnelle Antwort. Genau hier beginnt Inference Engineering: die Arbeit daran, aus einem Modell einen planbaren, wirtschaftlichen und belastbaren Dienst zu machen.
Für eine Open-Weight-KI im eigenen Rechenzentrum ergänzen sich zwei Projekte besonders gut: vLLM führt das Modell aus und organisiert die Arbeit auf den GPUs. llm-d koordiniert die Verteilung von Inferenzanfragen über eine Kubernetes-Infrastruktur. Zusammen bilden sie wichtige Bausteine einer privaten KI-Plattform. Anwendungen, Datenzugriff, Berechtigungen und Betriebsprozesse gehören zusätzlich dazu.
Die wichtigste Empfehlung
Starten Sie mit einem passenden Modell und einem schlanken, stabilen vLLM-Setup. Ergänzen Sie Replikate und intelligentes Routing, sobald die Last es verlangt. Trennen Sie Prefill und Decode erst dann, wenn Messungen den zusätzlichen Netzwerk- und Betriebsaufwand rechtfertigen.
Stand: 21. September 2026. Grundlage sind die verlinkten Projekt-Dokumentationen und Forschungsarbeiten. Architekturentscheidungen und Rechenbeispiele sind unsere Einordnung; dieser Beitrag enthält keine eigenen GPU-Benchmarks. „stable“, „latest“ und Projekt-Webseiten ändern sich: Für eine Umsetzung müssen Versionen und Hardwarekombinationen festgeschrieben werden.
1. Warum Inferenz anders skaliert als eine Webanwendung
Ein Sprachmodell verarbeitet Text als Tokens, also Textbausteine. Bei klassischer autoregressiver Generierung bestehen Anfragen aus zwei Phasen. Im Prefill verarbeitet das Modell den Prompt und baut seinen internen Kontext auf. Im Decode erzeugt es die Antwort schrittweise; jedes neue Token hängt von den vorherigen ab.
Lange Prefills benötigen häufig viel Rechenleistung. Decode ist bei vielen typischen Lasten stärker durch Speicherbandbreite begrenzt. Das sind hilfreiche Faustregeln, keine Naturgesetze: Modellarchitektur, Batchgröße, Kontextlänge und Hardware verändern den Engpass. Werden beide Phasen auf derselben GPU gemischt, kann ein langer neuer Prompt die laufenden Antworten anderer Nutzer ausbremsen. Die llm-d-Dokumentation zur Disaggregation beschreibt genau diesen Konflikt.
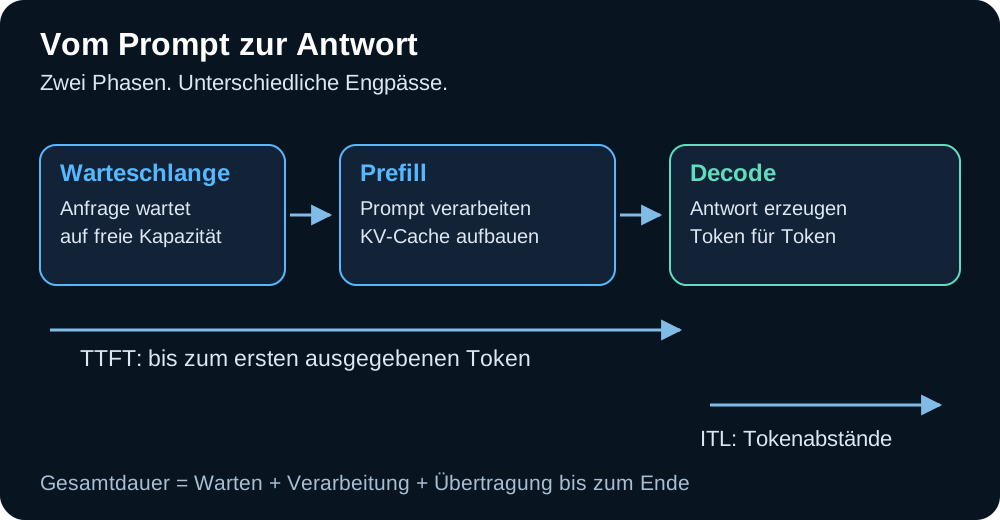
Deshalb reichen Anfragen pro Sekunde und GPU-Auslastung als Erfolgsmaß nicht aus. Time to First Token (TTFT) beschreibt die Wartezeit bis zum ersten Token. Inter-Token Latency (ITL) erfasst die Abstände während der Ausgabe. Time per Output Token (TPOT) beschreibt üblicherweise einen Durchschnitt pro Anfrage nach dem ersten Token; kurze Ausgabepausen können darin verschwinden. Dazu kommt die Gesamtdauer. Ein Dienst kann hohen Durchsatz erzielen und sich trotzdem langsam anfühlen.
2. Was vLLM auf dem Inferenzserver übernimmt
vLLM ist eine Inferenz- und Serving-Engine. Besonders wichtig sind drei Mechanismen:
- Effiziente KV-Cache-Verwaltung: Der Key-Value-Cache speichert Zwischenergebnisse der Attention-Berechnung für bereits verarbeitete Tokens. PagedAttention organisiert diesen Speicher in Blöcken und reduziert Verschwendung durch Fragmentierung. Es komprimiert dadurch nicht automatisch die Modellgewichte.
- Continuous Batching: Fertige Anfragen verlassen den laufenden Batch; neue können nachrücken. Die GPU wartet nicht darauf, dass die längste Antwort eines starren Batches fertig wird.
- Chunked Prefill: Lange Prompts werden in kleinere Verarbeitungsschritte zerlegt. So lassen sich neue Prompts und laufende Decodes besser miteinander vereinbaren. Die Größe des Tokenbudgets beeinflusst das Verhältnis zwischen Durchsatz, TTFT und flüssiger Ausgabe.
Das ursprüngliche PagedAttention-Paper erklärt die Speicherverwaltung; die aktuelle vLLM-Anleitung zur Optimierung beschreibt das Tuning. Historische Beschleunigungsfaktoren aus dem Paper sind keine Leistungszusage für heutige Modelle.
Automatic Prefix Caching spart zusätzlich Rechenarbeit, wenn Anfragen denselben Tokenpräfix teilen. Ein unveränderter Systemprompt oder wiederholt abgefragtes Dokument kann davon profitieren. Ähnliche Bedeutung allein genügt nicht. Ein Zeitstempel am Anfang des Prompts kann die Wiederverwendung verkürzen. Der Cache beschleunigt vor allem den Prefill; er ist kein Antwortcache und macht lange neue Antworten nicht automatisch schneller. Das grenzt auch die vLLM-Dokumentation ausdrücklich ein.
3. Was llm-d zusätzlich ermöglicht
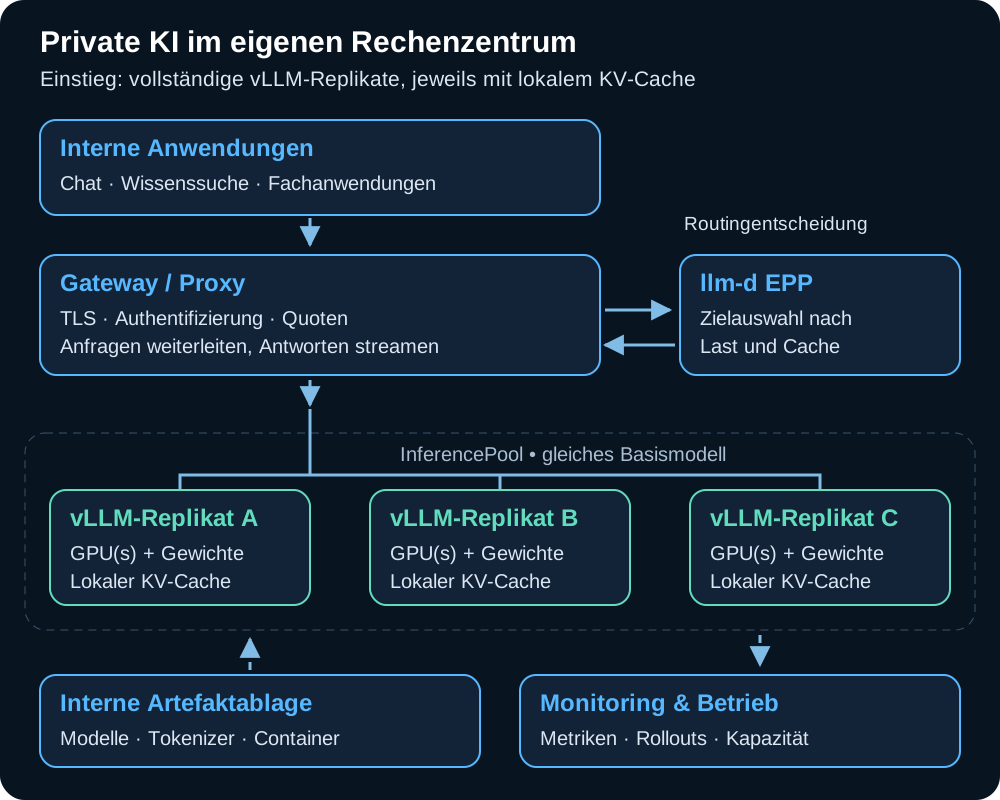
Mit mehreren vLLM-Replikaten entsteht eine neue Frage: Welcher Server soll die nächste Anfrage bekommen? Eine gleichmäßige Verteilung nach Anzahl der Anfragen kennt weder deren Länge noch vorhandene Cache-Inhalte. Ein Server mit zwei langen Dokumenten kann stärker beschäftigt sein als einer mit zehn kurzen Fragen.
llm-d ergänzt dafür eine Routing-Schicht. Der Proxy nimmt die Anfrage entgegen und fragt den Endpoint Picker (EPP) nach einem geeigneten Ziel. Dieser kann Warteschlangen, Cache-Affinität und weitere konfigurierte Signale berücksichtigen. Ein InferencePool fasst passende Modellserver zusammen. Wichtig: Der EPP verteilt Anfragen; der Kubernetes-Scheduler platziert Pods auf Nodes. Das sind unterschiedliche Aufgaben. Die Komponenten sind in der llm-d-Architektur beschrieben.
Cache-bewusstes Routing bedeutet zunächst, Arbeit zu einem vorhandenen Cache zu schicken. Es erzeugt nicht automatisch einen gemeinsamen GPU-Speicher. Präzise Cache-Indizes, Offloading, Disaggregation und Autoscaling sind zusätzliche, gezielt zu konfigurierende Funktionen. Zu starke Cache-Affinität kann einen bereits ausgelasteten Server weiter belasten. Der Routinggewinn entsteht aus dem Zusammenspiel von Wiederverwendung und Lastverteilung.
4. GPU-Speicher planen: Das Modell ist nur der Anfang
Eine grobe Rechnung für die Gewichte lautet: Parameterzahl × Bytes pro Parameter. Ein hypothetisches dichtes Modell mit 8 Milliarden Parametern benötigt bei zwei Bytes pro Parameter ungefähr 16 GB, also 14,9 GiB, allein für seine Gewichte. Ein Modell mit 70 Milliarden Parametern liegt bei ungefähr 140 GB. Laufzeitpuffer, Aktivierungen, CUDA-Graphs und KV-Cache kommen hinzu.
Für einen klassischen Transformer mit gleich aufgebauten Attention-Schichten lässt sich der unkomprimierte KV-Speicher pro Token näherungsweise so berechnen:
KV-Bytes pro Token = 2 × Schichten × KV-Heads × Head-Dimension × Bytes
Beispiel: 2 × 32 × 8 × 128 × 2 = 131.072 Bytes = 128 KiB
8.192 gespeicherte Tokens je Anfrage → ungefähr 1 GiB KV-Cache
32 solche Anfragen ohne geteilte Präfixe → ungefähr 32 GiB
Die Zwei am Anfang steht für Keys und Values. Im Beispiel beziehen sich 8.192 Tokens auf den bereits gespeicherten Kontext einschließlich erzeugter Tokens. Das ist eine illustrative Speicherrechnung, kein konkretes Modellprofil und kein Durchsatzbenchmark. Andere Attention-Architekturen, Sliding Windows, KV-Datentypen, Prefix-Sharing und die Verteilung über GPUs verändern sie. Bei Tensor Parallelism können einzelne Bestandteile zudem repliziert statt gleichmäßig geteilt werden.
Damit wird die Falle sichtbar: Ein Modell kann bequem in den Speicher passen und unter parallelen langen Anfragen trotzdem an Grenzen stoßen. Prüfen Sie den von vLLM beim Start gemeldeten verfügbaren KV-Cache und testen Sie den tatsächlichen Lastmix. Die Dokumentation zur Kapazität und Parallelisierung erklärt diese Startmeldungen.
Quantisierung kann den Speicherbedarf reduzieren. Sie ist jedoch eine Entscheidung über Modellqualität, unterstützte Kernel und Hardware, nicht nur ein Schalter für weniger Bytes. Gewichtsquantisierung und KV-Cache-Quantisierung sind getrennte Maßnahmen. Messen Sie Genauigkeit auf Ihren Aufgaben und Leistung auf der vorgesehenen Plattform; die vLLM-Kompatibilitätsübersicht ist dafür ein Ausgangspunkt.
5. Die richtige Form der Skalierung wählen
| Bedarf | Sinnvoller nächster Schritt | Wichtiger Preis |
|---|---|---|
| Modell passt auf eine GPU; mehr gleichzeitige Nutzer | Weitere vollständige Replikate und lastbewusstes Routing | Gewichte und lokale Caches werden mehrfach gehalten |
| Modell oder notwendiger KV-Cache passt nicht auf eine GPU | Tensor Parallelism innerhalb eines gut verbundenen Servers prüfen | Häufige Kommunikation zwischen GPUs |
| Modell benötigt mehrere Server | Tensor- und Pipeline-Parallelisierung passend zur Topologie kombinieren | Netzwerkabhängigkeit und größere Ausfalldomäne |
| Lange Prefills stören laufende Antworten trotz Tuning | Getrennte Prefill- und Decode-Pools vergleichen | KV-Transfer, zusätzliche Modellkopien und komplexerer Betrieb |
Tensor Parallelism teilt Berechnungen eines Modells auf GPUs auf. Pipeline Parallelism verteilt Modellschichten auf aufeinanderfolgende Stufen. Replikate erhöhen dagegen die Zahl unabhängig bedienbarer Anfragen. Für Mixture-of-Experts-Modelle kommt Expert Parallelism hinzu; aktive Parameter pro Token sagen dort wenig über den gesamten zu haltenden Gewichtsspeicher aus. Die vLLM-Skalierungsanleitung behandelt diese unterschiedlichen Wege.
Für die Beschaffung bedeutet das: Nicht nur GPU-Anzahl und VRAM vergleichen. GPU-zu-GPU-Verbindung, GPU-zu-Netzwerkkarte-Zuordnung, CPU-Leistung für Tokenisierung, Hauptspeicher, Modellladezeiten, Stromversorgung und Kühlung gehören in denselben Plan. Mehr GPUs helfen wenig, wenn die gewählte Parallelisierung auf eine langsame Verbindung wartet.
6. Prefill und Decode trennen: Ein Werkzeug mit Voraussetzungen
Bei disaggregiertem Serving verarbeitet ein spezialisierter Worker den Prompt. Ein anderer übernimmt die Ausgabe. Dazwischen muss der passende KV-Cache übertragen werden. Das erlaubt unterschiedliche Kapazitäten für beide Phasen und kann die gegenseitige Störung reduzieren. llm-d orchestriert diesen Ablauf; Transferkomponenten wie NIXL bewegen die Daten.
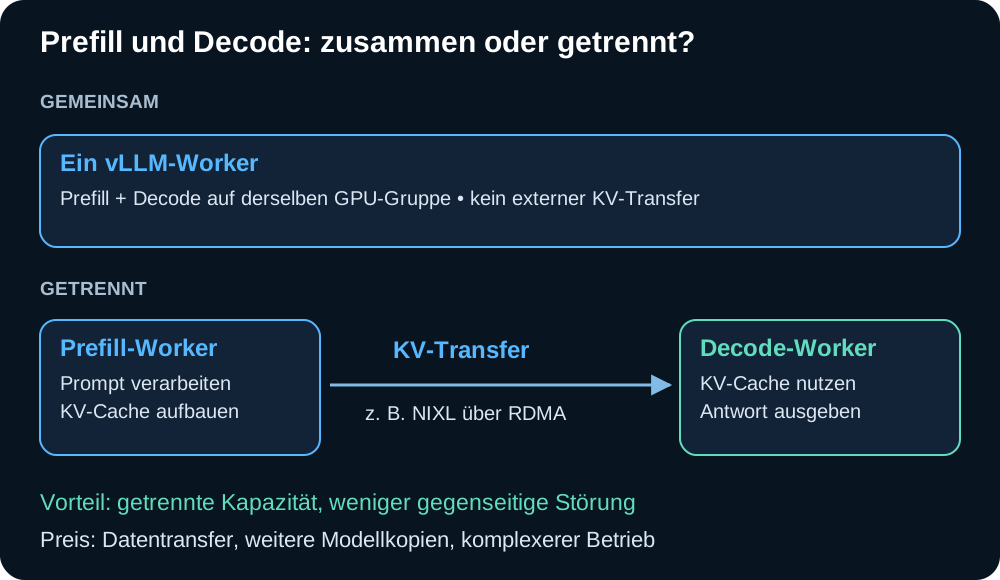
Der neue Engpass kann das Netzwerk werden. Als ideale Untergrenze braucht der Transfer von 1 GiB über einen exklusiv nutzbaren 100-Gbit/s-Link rund 86 Millisekunden: Bytes × 8 geteilt durch Bitrate. Protokolloverhead, Konkurrenzverkehr, Speicherregistrierung und Topologie verlängern das. Zehn gleichzeitige Transfers bekommen nicht jeweils die volle Leitung. Das ist eine Rechenillustration, kein gemessener NIXL-Wert.
Die llm-d-Anleitung verlangt für effiziente Disaggregation schnelle RDMA-Verbindungen und ordnet TCP-Fallback für diese Konfiguration als Entwicklungs- und Testweg ein. Die Netzwerkdokumentation erklärt die Prüfung von Transport und GPU/NIC-Topologie. Ein schneller Switch allein belegt noch keinen funktionierenden GPUDirect-RDMA-Pfad.
Unsere Entscheidungsregel: Erst Chunked Prefill und Replikat-Routing optimieren. Danach Disaggregation mit identischem Modell, gleicher Qualitätsanforderung und vergleichbarem GPU-Budget testen. Sie ist dann überzeugend, wenn zusätzliche nutzbare Kapazität oder bessere Antwortzeiten die Transfer- und Betriebskosten überwiegen. Bei kurzen Prompts, geringer Last oder starkem Prefix-Reuse kann der einfachere Aufbau gewinnen.
7. Ein realistischer Einstieg in den eigenen Betrieb
Beginnen Sie mit einem abgegrenzten Anwendungsfall, etwa einer internen Wissenssuche. Prüfen Sie Modellqualität auf deutschen Fachfragen, zulässige Nutzung, Kontextlänge und gegebenenfalls Tool-Calling oder strukturierte Ausgaben. Open Weight bedeutet verfügbare Gewichte unter den jeweiligen Bedingungen; es bedeutet nicht automatisch uneingeschränkte Nutzung oder offengelegte Trainingsdaten.
Für einen lokalen Funktionstest kann ein bereits geprüftes, unterstütztes Modell aus einem internen Verzeichnis geladen werden. Das folgende Beispiel setzt eine funktionierende vLLM-Installation, passende GPU-Treiber sowie ein Modell mit Chat-Template und mindestens 8.192 Tokens Kontext voraus:
vllm serve /srv/models/freigegebenes-chatmodell \
  --served-model-name intern-chat \
  --host 127.0.0.1 \
  --port 8000 \
  --max-model-len 8192 \
  --enable-prefix-caching
Das ist ein Startpunkt für einen lokalen Test, kein vollständiges Produktionsdeployment und keine hier auf GPUs ausgeführte Konfiguration. Prüfen Sie die Optionen mit vllm serve --help in Ihrer festgeschriebenen Version. Für Kubernetes müssen Listener, Services und Netzregeln passend zum Gateway konfiguriert werden. Chat-API-Kompatibilität bedeutet außerdem nicht, dass jedes Modell alle gewünschten Funktionen unterstützt.
Danach lässt sich der Ausbau in vier überprüfbare Schritte gliedern:
- Baseline messen: Ein Modell, eine Engine-Konfiguration, reale Prompt- und Antwortlängen. Qualität und Latenz gemeinsam abnehmen.
- Betrieb absichern: Internes Gateway, Authentifizierung, Tokenlimits, Monitoring, vorab bereitgestellte Artefakte und getestete Wiederanläufe.
- Replikate ergänzen: Auf getrennten Nodes betreiben und llm-d-Routing gegen eine einfache Lastverteilung vergleichen. Die offiziellen Scheduling-Guides dienen als Vorlage; einen passenden Release-Stand der verlinkten Manifeste verwenden.
- Engpässe gezielt beseitigen: Erst bei belegtem Bedarf Disaggregation, Cache-Offloading oder weitergehende Parallelisierung einführen.
Eine wirklich abgeschottete Umgebung braucht zusätzlich einen kontrollierten Importweg für Container, Gewichte, Tokenizer und Konfigurationen. Legen Sie Versionen beziehungsweise Digests fest und prüfen Sie den Start ohne Internetzugriff. Artefakte sollten nach Freigabe lokal verfügbar sein, damit ein Rollout nicht an einem externen Download hängt.
8. Messen, was Nutzer tatsächlich bekommen
Definieren Sie vor dem Benchmark ein Serviceziel. Ein rein beispielhaftes Ziel für kurze Chat-Anfragen könnte sein: 95 Prozent starten innerhalb von zwei Sekunden und haben eine durchschnittliche TPOT unter 50 Millisekunden. Für lange Dokumente brauchen Sie andere Klassen. ITL-Spitzen, Fehlerquote und Gesamtdauer separat beobachten; eine flüssige kurze Antwort darf eine stockende lange nicht statistisch verdecken.
Die entscheidende Kapazitätskennzahl ist Goodput: erfolgreich bediente Anfragen pro Zeit, die die vereinbarten Latenzgrenzen erfüllen. Abgelehnte und fehlgeschlagene Anfragen zusätzlich zur gesamten angebotenen Last ausweisen. Sonst sieht ein überlasteter Dienst gut aus, weil er den Großteil der Arbeit gar nicht annimmt. vLLM bench serve unterstützt Latenzgrenzen für Goodput-Auswertungen.
- Repräsentative Last: Kurze Chats, lange Dokumente, Ausgabegrößen, wiederholte Präfixe und Bursts in realistischen Anteilen.
- Saubere Vergleiche: Gleiche Modellrevision, Quantisierung, Sampling-Parameter, Tokenizer, Hardware und Ressourcenbudgets. Kalte und warme Caches getrennt ausweisen.
- Last bis zur Grenze: Ankunftsrate steigern; p50, p95 und p99, Warteschlangen, Fehler, Abbrüche und Goodput erfassen. Ein reiner Test mit konstanter Parallelität kann Überlast verdecken.
- Ausfall unter Last: Einen Worker verlieren, neue Replikate aufwärmen und einen Rollout durchführen. Streaming-Abbrüche sichtbar behandeln statt eine nahtlose Fortsetzung zu versprechen.
vLLM stellt über /metrics Prometheus-Metriken zu Latenzen, Tokenmengen und Cache-Nutzung bereit. Messen Sie zusätzlich am Client beziehungsweise Gateway: Dort werden Netz- und Routingwartezeiten sichtbar. Die Metrikdokumentation hilft beim Aufbau; Namen und Semantik müssen zur eingesetzten Version passen.
Autoscaling braucht freie physische Kapazität. Kubernetes kann keine GPUs herbeizaubern. Neue Pods müssen Gewichte laden, initialisieren und warm werden; ihre Präfix-Caches sind zunächst kalt. Nutzen Sie Warteschlangen- und Latenzsignale, halten Sie eine passende Reserve bereit und testen Sie geordnetes Drain vor dem Abschalten. Für Hochverfügbarkeit müssen auch Gateway, Routing und verbleibende GPU-Kapazität einen Node-Ausfall verkraften.
9. Datensouveränität entsteht durch den gesamten Datenfluss
Eigene Hardware schafft Kontrolle über den Ausführungsort. Ob vertrauliche Inhalte das Rechenzentrum verlassen können, entscheiden auch Telemetrie, Logs, externe Tools, Modellimporte und Medien-Downloads. Interne RAG-Suche braucht Berechtigungsfilter schon beim Dokumentabruf. Agenten brauchen begrenzte Tool-Rechte; der Modellserver übernimmt diese Anwendungskontrollen nicht.
Besonders konkret ist die vLLM-Sicherheitsdokumentation: Interne verteilte Kommunikation und KV-Transfers sind standardmäßig nicht für ungeschützte Netze ausgelegt. Segmentieren Sie diese Verbindungen und erlauben Sie nur notwendige Kommunikationspartner. TLS am Benutzer-Gateway schützt nicht automatisch den GPU-Datenpfad.
Für mehrere Mandanten gehören Quoten, zulässige Modelle, maximale Ein- und Ausgabelängen sowie ein bewusstes Cache-Isolationskonzept dazu. Sensible Prompts nicht standardmäßig protokollieren; Caches und Offloading-Speicher als schützenswerte Daten behandeln. Bei unterschiedlichen Vertrauenszonen können getrennte Pools sinnvoller sein als maximale Wiederverwendung. Modellcode, Plugins und Medienzugriffe nur kontrolliert freigeben.
10. Wann sich die eigene Plattform wirtschaftlich trägt
Der faire Vergleich lautet: Was kostet eine fachlich brauchbare, innerhalb des Serviceziels gelieferte Antwort? Anschaffung und Abschreibung, Strom, Kühlung, Netzwerk, Speicher, Personal, Wartung und Reservekapazität gehören in den Zähler. In den Nenner gehören erfolgreich nutzbare Antworten für denselben Lastmix. Eine Kennzahl pro Million Tokens ist ergänzend sinnvoll, wenn Eingabe und Ausgabe getrennt und Modellqualität sowie Latenzziele vergleichbar bleiben.
Schwankende Last und selten genutzte große Modelle können eigene Hardware teuer machen. Regelmäßige Auslastung, lokale Datenzugriffe und klare Anforderungen an den Ausführungsort können für sie sprechen. llm-d hilft, vorhandene Kapazität besser einzusetzen; eine höhere GPU-Auslastung allein beweist noch keine niedrigeren Gesamtkosten.
Der tragfähige Weg ist deshalb schrittweise: das kleinste fachlich ausreichende Modell auswählen, vLLM unter realistischer Last vermessen, den Betrieb absichern und dann mit llm-d wachsen. Eine gute Inferenzplattform liefert nachvollziehbare Antwortzeiten, beherrschbare Ausfälle und einen überprüfbaren Preis pro nutzbarer Antwort.
Vom Pilot zur belastbaren Architektur
Sie planen eine private KI-Plattform? EIST Consulting unterstützt bei Workload-Analyse, Modellbewertung, GPU- und Netzwerkplanung sowie beim Aufbau eines messbaren Betriebsmodells. Sprechen wir über Ihre Anforderungen.